¿Qué gráfica comprar para IA local? Guía para no equivocarte
VRAM, CUDA, ROCm, segunda mano o un Mac con memoria unificada: qué mirar al elegir una gráfica para ejecutar modelos de IA en tu propio ordenador.
Este artículo contiene enlaces de afiliado: si compras a través de ellos podemos recibir una comisión, sin coste para ti. Más información.
Para IA local, lo que más importa es la VRAM: compra la gráfica con más memoria que te permita el presupuesto, con 16 GB como punto dulce para modelos medianos. NVIDIA es la opción más sencilla por la compatibilidad de CUDA; AMD funciona bien en Ollama, LM Studio y llama.cpp, y un Mac o un mini PC con mucha memoria unificada es la alternativa para modelos grandes, a costa de velocidad.
Elegir gráfica para IA local no se parece a elegirla para jugar. En juegos manda la potencia del chip; para ejecutar modelos de lenguaje o generar imágenes en casa, lo primero es cuánta memoria tiene la tarjeta, y después lo rápido que puede leerla. Una gráfica modesta con mucha VRAM puede ser mejor compra que otra más potente con poca.
¿Qué es lo más importante en una gráfica para IA local?
Ordena tus prioridades así:
- VRAM: cuánto modelo cabe en la gráfica.
- Ecosistema de software: si tus programas funcionan sin pelearte con ellos.
- Ancho de banda de memoria: lo rápido que genera texto.
- Consumo, tamaño y ruido: que encaje en tu equipo y en tu fuente.
| Opción | Ventaja principal | Pega principal |
|---|---|---|
| NVIDIA (CUDA) | Máxima compatibilidad | Suele costar más por GB de VRAM |
| AMD (ROCm / Vulkan) | Buena VRAM por el precio | Menos proyectos la soportan de serie |
| Intel Arc | Precio contenido | Soporte de software más limitado |
| Mac o mini PC con memoria unificada | Mucha memoria para modelos grandes | Menos velocidad que una gráfica dedicada potente y no se puede ampliar |
¿Por qué la VRAM es lo que más importa?
Un modelo de IA tiene que estar cargado en memoria para funcionar. Si cabe entero en la VRAM de la gráfica, va rápido; si no cabe, herramientas como Ollama o llama.cpp mandan una parte a la RAM del sistema y la velocidad cae de forma muy notable.
Por eso, entre dos gráficas de precio parecido, para IA local suele compensar la que tiene más memoria, aunque sea algo menos potente en juegos. La memoria necesaria depende del tamaño del modelo, de la cuantización (lo comprimido que esté) y de la longitud del contexto. Como referencia, Gemma 3 en su versión habitual (Q4_K_M) ocupa 3,3 GB en 4B, 8,1 GB en 12B y 17 GB en 27B, a lo que hay que sumar el contexto.
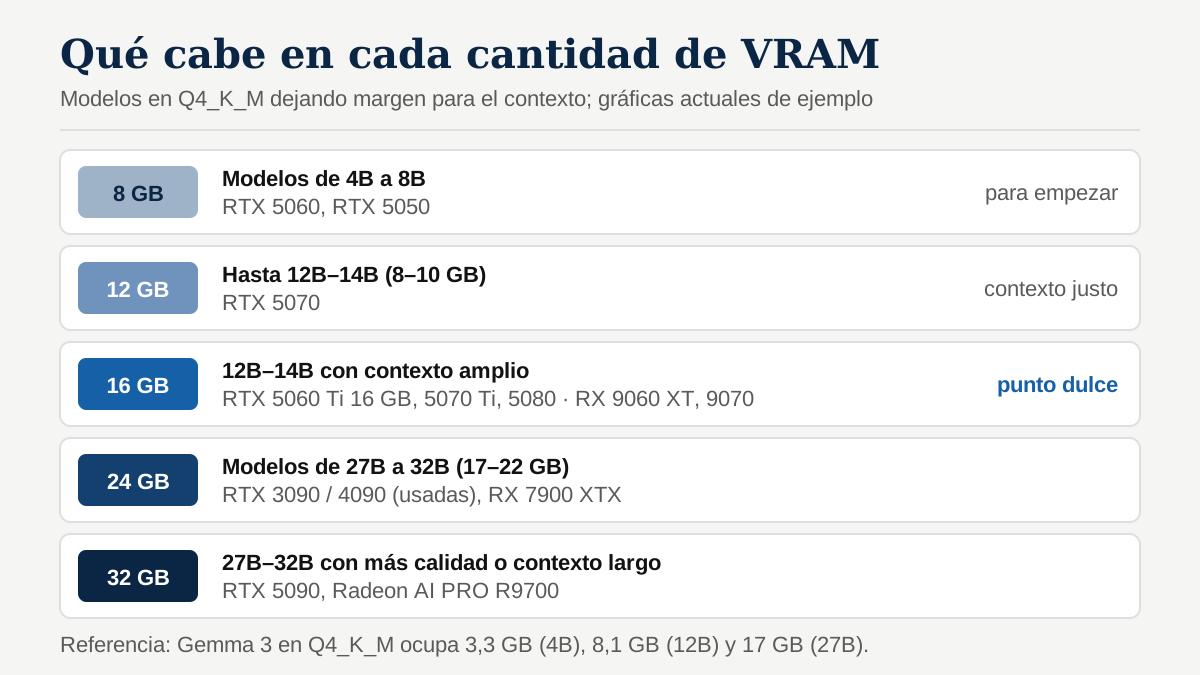
Algunas referencias generales de uso:
- Chat con modelos pequeños (de 4B a 8B, cuantizados): funcionan con gráficas de 8 GB.
- Modelos medianos (12B a 14B) y contextos largos: 12 GB van justos; 16 GB es el punto dulce.
- Modelos de 27B a 32B: piden 24 GB o más.
- Generación de imágenes: los modelos más recientes también agradecen mucha VRAM, sobre todo a alta resolución.
- Entrenar o hacer fine-tuning: necesita bastante más memoria que solo usar el modelo.
Lo explicamos con más detalle en cuánta VRAM necesito, y en qué es la cuantización y el formato GGUF verás por qué un mismo modelo puede ocupar 5 o 16 GB.
¿Qué gráficas actuales hay según su VRAM?
Estas son las cantidades de memoria de las gráficas de escritorio actuales según las especificaciones de NVIDIA y AMD:
| VRAM | NVIDIA | AMD |
|---|---|---|
| 8 GB | RTX 5050, RTX 5060, RTX 5060 Ti 8 GB | — |
| 12 GB | RTX 5070 | — |
| 16 GB | RTX 5060 Ti 16 GB, RTX 5070 Ti, RTX 5080 | RX 9060 XT, RX 9070, RX 9070 XT |
| 20–24 GB | RTX 4090 y RTX 3090 (generaciones anteriores) | RX 7900 XT (20 GB), RX 7900 XTX (24 GB) |
| 32 GB | RTX 5090 | Radeon AI PRO R9700 (gama profesional) |
Ojo con la RTX 5060 Ti: existe en versiones de 8 y 16 GB con el mismo nombre. Para IA local, la de 16 GB es la que interesa.
¿Por qué importa el ancho de banda?
Para escribir cada palabra (cada token), el equipo tiene que leer el modelo entero de la memoria. Por eso, una vez que el modelo cabe, la velocidad de generación depende sobre todo del ancho de banda de memoria. Las pruebas publicadas en el repositorio de llama.cpp lo reflejan: el mismo modelo de 8B genera más del doble de rápido en Q4_K_M que en 16 bits, simplemente porque hay menos datos que mover.
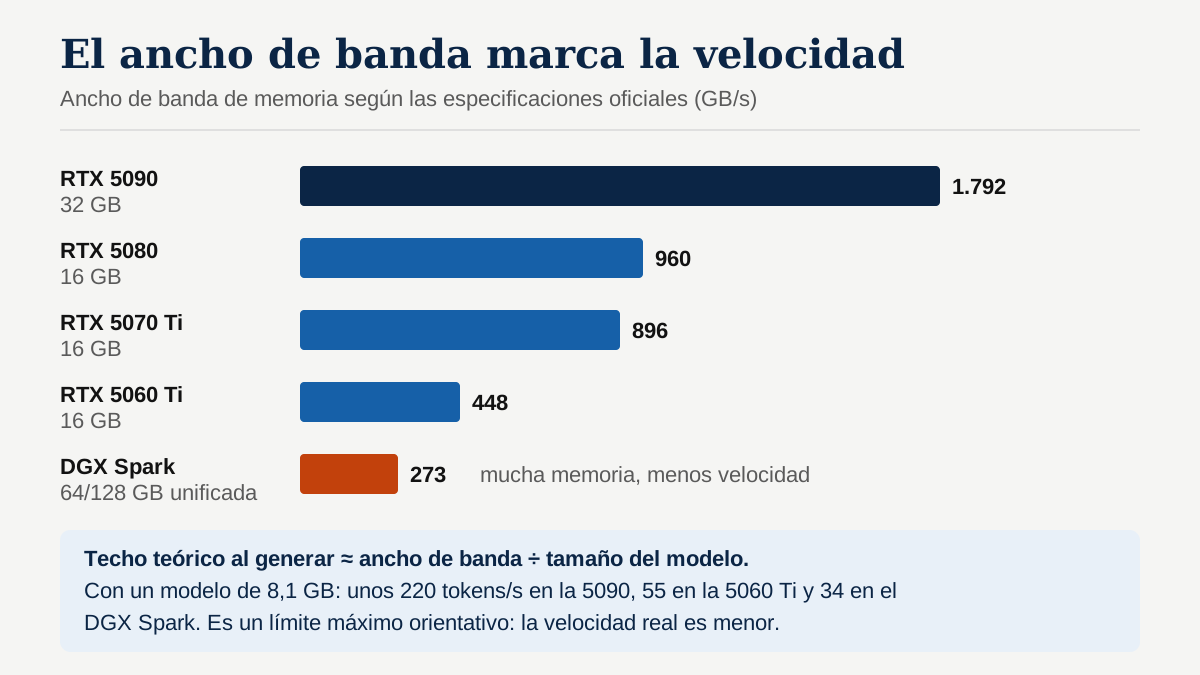
Una forma rápida de estimar el techo teórico es dividir el ancho de banda entre el tamaño del modelo. La velocidad real queda por debajo, pero sirve para comparar: entre una RTX 5060 Ti de 16 GB (448 GB/s) y una RTX 5070 Ti (896 GB/s), las dos cargan los mismos modelos, pero la segunda puede generar texto hasta el doble de rápido.
¿Por qué NVIDIA y CUDA son la opción sin sorpresas?
CUDA es la plataforma de cálculo de NVIDIA y lleva muchos años siendo el estándar de facto en IA. La consecuencia práctica es que casi cualquier proyecto (PyTorch, interfaces de generación de imágenes, herramientas de transcripción, scripts de GitHub) funciona primero, y mejor documentado, en una NVIDIA.
Si quieres experimentar con muchas herramientas distintas y no perder tiempo con instalaciones, NVIDIA es lo más cómodo. El precio a pagar es que, a igualdad de VRAM, suelen ser más caras, y las gamas con mucha memoria se disparan de precio. En Ollama, por ejemplo, se admiten gráficas NVIDIA con capacidad de cómputo 5.0 o superior y drivers 550 o posteriores, lo que cubre muchas generaciones atrás.
¿Sirve una gráfica AMD para IA local?
AMD ofrece ROCm como alternativa a CUDA. En Windows, su HIP SDK (versión 7.2) admite oficialmente las Radeon con arquitectura RDNA 3 y RDNA 4, es decir, las RX 7000 y RX 9000; las RX 6000 y anteriores no aparecen como compatibles. Además, herramientas como llama.cpp y Ollama pueden usar Vulkan, que funciona en una gama más amplia de gráficas.
En la práctica, para chatear con modelos de lenguaje con Ollama, LM Studio o llama.cpp, una AMD con mucha VRAM es una opción muy razonable: la RX 7900 XTX ofrece 24 GB y las RX 9060 XT y 9070, 16 GB. Para proyectos más específicos, cuenta con que puede tocar buscar instrucciones concretas o que algo no funcione a la primera.
¿Y una Intel Arc?
Las gráficas Intel Arc tienen precios ajustados y se pueden usar para IA a través de backends como Vulkan o SYCL en llama.cpp; Ollama también las aprovecha mediante Vulkan. Es la opción con menos recorrido de las tres: funciona para lo básico, pero encontrarás menos guías y menos programas compatibles de serie. Interesante si ya tienes una o si el presupuesto es muy cerrado.
¿Merece la pena una gráfica de segunda mano para IA?
Muchas personas que montan un equipo para IA local miran el mercado de segunda mano, porque las gráficas de gama alta de generaciones anteriores con 24 GB, como la RTX 3090, no tienen equivalente nuevo a un precio parecido. Si vas por aquí:
- Pide que te enseñen la gráfica funcionando con carga y revisa temperaturas.
- Comprueba si queda garantía y si es transferible.
- Revisa que tu fuente tenga potencia y conectores suficientes, y que la tarjeta quepa en la caja. Te ayudamos a calcularlo en qué fuente de alimentación necesito.
- Desconfía de precios muy por debajo de lo habitual.
- Ten en cuenta que las generaciones antiguas pueden quedarse sin soporte en versiones futuras de los drivers o de CUDA.
¿Es el Mac una buena alternativa para IA local?
Los Mac con Apple Silicon usan memoria unificada: la CPU y la gráfica comparten la misma memoria. Un Mac con mucha memoria puede dedicar buena parte de ella al modelo y cargar modelos que en un PC requerirían varias gráficas.
Ventajas: silencio, bajo consumo y que todo cabe en un equipo compacto; Ollama, LM Studio (que además usa modelos MLX optimizados para Apple Silicon) y llama.cpp funcionan bien en macOS. Inconvenientes: la memoria no se puede ampliar después (hay que acertar al comprar), la velocidad de generación suele quedar por debajo de una gráfica dedicada potente cuando el modelo cabe en ella, y parte del software de IA está pensado para CUDA.
La misma idea llega al PC con los mini PC de memoria unificada, como los basados en Ryzen AI Max+ PRO 495 o el NVIDIA DGX Spark, que ofrece 64 o 128 GB pero con 273 GB/s de ancho de banda, muy lejos de los 1.792 GB/s de una RTX 5090. Para quien quiere modelos grandes sin montar un PC con varias gráficas, son una opción seria, sabiendo que irán más despacio.
¿Qué gráfica comprar según tu presupuesto?
No damos precios porque el mercado de gráficas cambia muy rápido (y en 2026 la memoria se ha encarecido mucho), pero sí una orientación por tramos:
| Tramo | Qué buscar | Para qué alcanza |
|---|---|---|
| Ajustado | La gráfica con más VRAM que puedas; evita las de 8 GB si puedes llegar a 16 | Modelos pequeños cuantizados, pruebas, transcripción |
| Medio | 16 GB: RTX 5060 Ti 16 GB, RX 9060 XT o RX 9070 | Modelos medianos y generación de imágenes con soltura |
| Alto | 24–32 GB: RTX 3090 usada, RX 7900 XTX, RTX 5090, o dos gráficas | Modelos de 27B–32B, contextos largos, uso intensivo |
| Alternativa | Mac o mini PC con mucha memoria unificada | Modelos muy grandes en un equipo silencioso, más lentos |
Y no te olvides del resto del equipo: una fuente de calidad con margen, buena ventilación y suficiente RAM del sistema para cuando el modelo no quepa entero en la gráfica.
¿Qué errores conviene evitar?
- Elegir por rendimiento en juegos y quedarse corto de VRAM.
- Comprar la versión de 8 GB de un modelo que también existe con 16 GB.
- Comprar una AMD o Intel sin comprobar si el programa concreto que quieres usar la soporta.
- Olvidar la fuente de alimentación al pasar a una gráfica de gama alta.
- En Mac, comprar con poca memoria pensando ampliarla luego.
¿Cuál elegimos? Nuestra recomendación
Empieza por decidir qué modelos quieres ejecutar y mira en cuánta VRAM necesito o en la herramienta ¿qué IA puedo ejecutar? cuánta memoria piden. Después, busca la gráfica con más VRAM dentro de tu presupuesto: 16 GB es hoy el punto de equilibrio para la mayoría, y 24 GB o más si quieres modelos de 27B a 32B. Si quieres cero complicaciones y probar de todo, elige NVIDIA; si lo tuyo es sobre todo chatear con modelos de lenguaje y quieres más memoria por euro, una AMD RX 7000 o RX 9000 es una buena opción. Si quieres mover modelos muy grandes en un equipo silencioso y no te importa sacrificar velocidad, valora un Mac o un mini PC con mucha memoria unificada. Y si guardas modelos, datasets y resultados, piensa también en dónde almacenarlos: un NAS puede ayudarte.
Según los usuarios de Hacker News, la RTX 3090 usada de 24 GB sigue siendo probablemente la gráfica más recomendada en la comunidad de modelos locales, porque permite mover modelos de 27B en Q4 con margen para el contexto. Eso sí, los propios usuarios reflejan lo mucho que ha subido: en marzo de 2026 se hablaba de unos 900 dólares y en agosto ya se citaban 1.500, así que compara siempre con el precio de una gráfica nueva de 16 GB antes de decidir. También hay quien usa con éxito una Radeon RX 7900 XT de 20 GB con Ollama para programar.
Preguntas frecuentes
¿Es mejor una gráfica más potente o una con más VRAM?+
Para IA local, casi siempre la de más VRAM. Si el modelo no cabe en la memoria de la gráfica, parte se carga en la RAM del sistema y la velocidad cae mucho, por potente que sea el chip. Entre dos gráficas con la misma VRAM, decide el ancho de banda de memoria.
¿Sirve una gráfica AMD para IA local?+
Sí para las herramientas más populares, como Ollama, LM Studio o llama.cpp. En Windows, el soporte oficial de ROCm cubre las Radeon RX 7000 y RX 9000; las RX 6000 quedan fuera, aunque pueden funcionar mediante Vulkan. Fuera de esas herramientas, muchos proyectos se prueban primero con CUDA.
¿Puedo usar dos gráficas a la vez?+
Sí. Herramientas como llama.cpp u Ollama pueden repartir un modelo entre varias gráficas y sumar su VRAM. Necesitas una placa con ranuras suficientes, una fuente con margen y buena ventilación, y la velocidad no se suma igual que la memoria.
¿Merece la pena comprar una gráfica de segunda mano para IA?+
Puede ser la mejor relación VRAM/precio, y la RTX 3090 de 24 GB es la más citada por la comunidad. Revisa el estado, las temperaturas y la garantía restante, y desconfía de precios demasiado bajos.
Fuentes
- NVIDIA: comparativa de especificaciones GeForce (memoria y ancho de banda)
- NVIDIA DGX Spark: especificaciones
- AMD ROCm: especificaciones de arquitectura de GPU (VRAM de Radeon)
- AMD HIP SDK para Windows: requisitos del sistema
- Documentación de Ollama: hardware compatible
- Biblioteca de modelos de Ollama: gemma3
- llama.cpp: documentación de la herramienta quantize (velocidad según cuantización)
- Documentación de LM Studio: requisitos del sistema
- Hacker News: comentario sobre la RTX 3090 usada y la cuantización (marzo de 2026)
- Hacker News: Ask HN: Who uses open LLMs and coding assistants locally?
- Hacker News: comentario sobre el precio de la RTX 3090 usada (agosto de 2026)