¿Qué es Ternary Bonsai 2 27B, el modelo de IA de 27B que ocupa unos 6-7 GB?
PrismML comprime Qwen3.8-27B a entre 5,95 y 7,21 GB con pesos ternarios y dice conservar el 98,2 % de su rendimiento. Qué es, qué necesita y sus limitaciones.
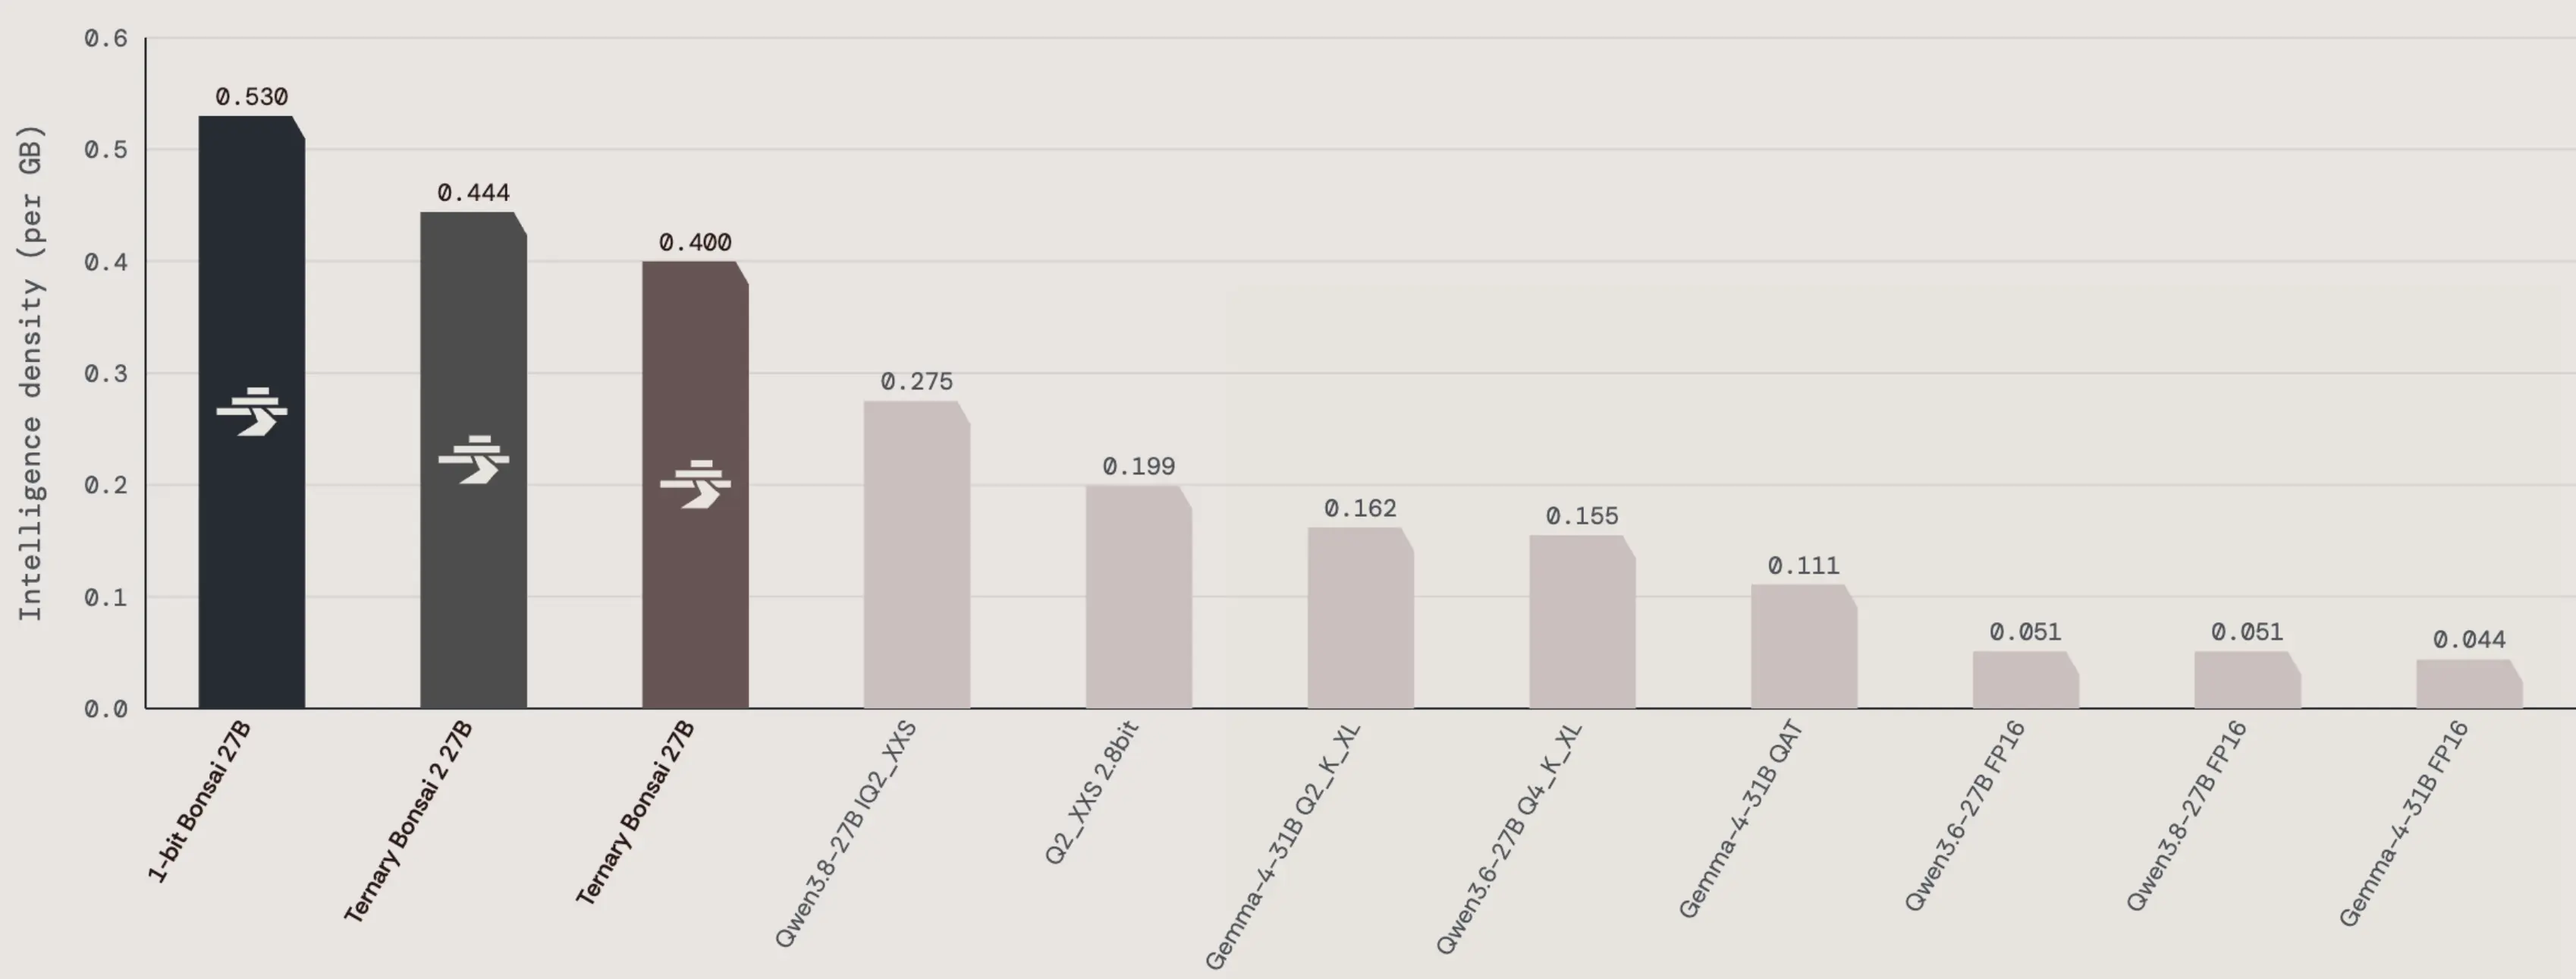
Imagen: PrismML
Este artículo contiene enlaces de afiliado: si compras a través de ellos podemos recibir una comisión, sin coste para ti. Más información.
Ternary Bonsai 2 27B es una versión muy comprimida de Qwen3.8-27B creada por PrismML y publicada a mediados de septiembre de 2026 con licencia Apache 2.0. Sus archivos ocupan entre 5,95 y 7,21 GB frente a casi 54 GB del original, pero por ahora necesita una versión modificada de llama.cpp y no funciona con Ollama ni LM Studio estándar.
¿Qué se ha anunciado?
La empresa PrismML publicó a mediados de septiembre de 2026 (el 17 de septiembre, según medios como DataNorth) Ternary Bonsai 2 27B, una versión comprimida del modelo abierto Qwen3.8-27B de Alibaba. La novedad es el tamaño: usa pesos “ternarios” (cada peso solo puede tomar tres valores) y, según la ficha oficial en Hugging Face, los archivos quedan así:
- PTQ1_0: 5,95 GB (unos 1,75 bits por peso).
- PQ2_0: 7,21 GB (unos 2,13 bits por peso).
- Referencia F16 original: 53,8 GB.
PrismML afirma que conserva el 98,2 % del rendimiento del modelo original en su batería de pruebas (84,78 puntos de media frente a 86,32) y que supera claramente a las cuantizaciones convencionales a 2 bits. Mantiene el contexto de 262.000 tokens y la capacidad de entender imágenes. Se distribuye con licencia Apache 2.0 en formatos GGUF y MLX (para Mac).
¿Cuánto cuesta y cuándo llega a España?
Los pesos son gratuitos y ya se pueden descargar desde Hugging Face en cualquier país. Quien no quiera ejecutarlo en local puede usarlo por API en OpenRouter, que cobra por tokens en dólares.
¿Qué cambia frente a Qwen3.8-27B “normal”?
La diferencia es práctica: el modelo original necesita unos 54 GB en precisión completa, y una cuantización típica a 4 bits suele ocupar más del doble que Bonsai 2. Con 6-7 GB de pesos, un modelo de 27B se acerca a lo que hasta ahora ocupaban modelos de 8B a 4 bits. Si quieres entender por qué esto importa, lee cuánta VRAM necesitas para IA local y qué es la cuantización GGUF.
Pero hay letra pequeña importante:
- No funciona con llama.cpp estándar: la ficha lo dice expresamente. Hay que usar la versión modificada de PrismML (que ofrece binarios precompilados o se puede compilar), así que de momento no sirve con Ollama ni LM Studio tal como vienen.
- Pérdidas desiguales: según DataNorth, programación y matemáticas se mantienen, pero el conocimiento general y la comprensión de imágenes pierden más.
- Rendimiento variable según la gráfica: PrismML publica unos 130 tokens/s en una RTX 5090 y unos 47 tokens/s en un MacBook con M5 Max, y avisa de que el formato más compacto es más pesado de “desempaquetar” en algunas arquitecturas.
¿Para quién es?
Para usuarios con algo de experiencia que no tienen miedo a compilar herramientas y quieren probar un modelo grande en un equipo con poca VRAM. Si buscas algo que funcione a la primera, lo sensato es esperar a que el soporte llegue a las herramientas habituales; mientras tanto, puedes empezar con Ollama en Windows o comparar opciones en Ollama vs LM Studio. Para ver qué modelos encajan en tu equipo, usa ¿qué IA puedo ejecutar?.
Nuestra opinión
Esto es opinión. El lanzamiento ha despertado mucho interés entre la comunidad de IA local (el debate en Hacker News superó los 500 puntos y los 200 comentarios): los usuarios destacan que un modelo de 27B quepa en gráficas modestas y comparten velocidades altas en GPU de consumo. Las críticas son igual de claras: depender de una versión modificada de llama.cpp en lugar de la oficial, dudas sobre la etiqueta de «casi sin pérdidas» porque las pruebas son del propio PrismML, y testimonios de bucles y peores resultados en tareas de agente y de razonamiento largo. DataNorth, con los datos del propio PrismML, apunta además a pérdidas de unos 5-6 puntos en conocimiento general y en comprensión de imágenes. Para quien tenga poca VRAM y no le importe usar herramientas específicas merece la pena probarlo; quien ya pueda ejecutar con soltura una cuantización de 4 bits del Qwen3.8-27B original no tiene, de momento, una razón clara para cambiar.
Preguntas frecuentes
¿Funciona Ternary Bonsai 2 27B en Ollama o LM Studio?+
No por ahora. La ficha oficial en Hugging Face advierte de que llama.cpp estándar no puede ejecutar estos archivos y que hay que usar la versión modificada de PrismML; por tanto, tampoco funciona con Ollama ni LM Studio tal como vienen.
¿Cuánta calidad pierde frente al modelo original?+
PrismML afirma que conserva el 98,2 % de la puntuación media del modelo original en sus pruebas (84,78 frente a 86,32). Son datos del propio desarrollador; medios como DataNorth señalan pérdidas más visibles en conocimiento general y comprensión de imágenes.
¿Es gratis?+
Sí, los pesos se publican con licencia Apache 2.0 en Hugging Face. También se puede usar de pago por API a través de OpenRouter.
¿Qué hardware necesito?+
PrismML publica pruebas con GPU NVIDIA (RTX 4090, RTX 5090) y Mac con chip M5 Pro/Max, y su versión de llama.cpp también permite ejecutarlo solo en CPU. Al ocupar 6-7 GB, en teoría cabe en gráficas con menos VRAM que el modelo original, aunque el desarrollador no da una lista cerrada de requisitos mínimos.
Fuentes
- Hugging Face – prism-ml/Ternary-Bonsai-2-27B-gguf (ficha oficial)
- Hugging Face – perfil de PrismML (colección Bonsai 2)
- DataNorth – PrismML brengt Ternary Bonsai 2 27B uit
- Hugging Face – Qwen/Qwen3.8-27B (modelo base)
- OpenRouter – PrismML: Ternary Bonsai 2 27B
- Hacker News – Debate sobre «Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint»