¿Va más rápido Ollama en Mac con la versión 0.40?
Ollama 0.40.0 usa por defecto MLX, el motor de Apple, en los Mac con Apple Silicon. Qué cambia, qué modelos lo aprovechan, cuánta memoria hace falta y qué pasa si usas Windows.
Este artículo contiene enlaces de afiliado: si compras a través de ellos podemos recibir una comisión, sin coste para ti. Más información.
En muchos casos, sí. Ollama publicó el 6 de octubre de 2026 la versión 0.40.0, que en los Mac con Apple Silicon ejecuta automáticamente con MLX, el motor de aprendizaje automático de Apple, los modelos compatibles, como Qwen 3.8, Gemma 4, Qwen 3.6 y Qwen 3.5. No hay que cambiar ningún comando; en Windows y Linux esta versión no trae cambios de rendimiento.
¿Qué ha cambiado en Ollama?
Ollama, una de las herramientas gratuitas más populares para ejecutar modelos de IA en tu propio ordenador, publicó el 6 de octubre de 2026 la versión estable 0.40.0 tras varias versiones de prueba. La novedad principal solo afecta a los Mac: en los equipos con Apple Silicon, los modelos cuya arquitectura admite el motor MLX de Ollama se ejecutan con MLX de forma automática.
MLX es el marco de aprendizaje automático de código abierto de Apple, pensado para aprovechar la memoria unificada de sus chips. Ollama lo probaba desde marzo como opción preliminar; ahora pasa a ser lo predeterminado. No hay que cambiar nada: los comandos ollama pull y ollama run y la API funcionan igual, como recogía heise online el 7 de octubre. Según su documentación, Ollama para Mac necesita macOS Sonoma (14) o posterior.
Qué modelos lo aprovechan
| Modelo en Ollama | Tamaño de la versión MLX | Mac recomendado (estimación) |
|---|---|---|
| gemma4:e4b-mlx | 9,5 GB | 16 GB |
| gemma4:12b-mlx | 7,7 GB | 16 GB |
| qwen3.8:27b-mlx | 18 GB | 32 GB |
| gemma4:26b-mlx | 18 GB | 32 GB |
| gemma4:31b-mlx | 19 GB | 32 GB |
Los tamaños son los que muestra la biblioteca de Ollama; la columna de la derecha es nuestra estimación. Ten en cuenta que macOS solo deja a la gráfica en torno al 75 % de la memoria por defecto y que el contexto también ocupa memoria, como explicamos en cuánta VRAM necesito. Por eso un modelo de 18 GB va muy justo en un Mac de 24 GB. Si dudas entre estos modelos, en nuestro comparador de modelos de IA puedes poner frente a frente los de pesos abiertos que se ejecutan en local, como Qwen3.8-27B y Gemma 4.
Además de estos modelos de lenguaje, la 0.40.0 lleva a MLX los modelos de decisión Nimble, tev1, clef y clef-flash y el modelo de embeddings EmbeddingGemma 2, útil para buscar en tus documentos (lo contamos en chatear con tus documentos en local). Los modelos que MLX aún no admite siguen funcionando con el motor de siempre.
¿Cuánto más rápido va?
Ollama no da cifras nuevas para la 0.40.0, pero sí ha publicado mediciones de su motor MLX durante el año:
- Marzo de 2026: con Qwen3.5-35B-A3B, la generación pasó de 58 a 112 tokens por segundo y el procesado del prompt, de 1.154 a 1.810 tokens por segundo. Ojo: comparaba la versión MLX en formato NVFP4 con la anterior en Q4_K_M, así que no es una comparación con el mismo archivo.
- Junio de 2026: Ollama habló de hasta un 20 % más de velocidad de salida tras actualizar el motor, medido en un MacBook Pro con M5 Max.
Son cifras del propio Ollama en su hardware. En un Mac con un chip M1 o M2 y menos memoria la mejora será distinta, y en los chips M5, M5 Pro y M5 Max Ollama aprovecha además los aceleradores neuronales de la gráfica.
ollama pull los que tengan versión MLX (por ejemplo, qwen3.8). Para saber qué modelos caben en tu equipo, prueba nuestra herramienta ¿qué IA puedo ejecutar?.¿Y si usas Windows o Linux?
Las notas de la versión solo hablan de Apple Silicon. Si usas Ollama en Windows con una gráfica NVIDIA o AMD, la 0.40.0 no cambia el rendimiento; actualizar sigue siendo recomendable por las correcciones. Si estás empezando, tienes la guía para instalar Ollama en Windows y la comparativa Ollama o LM Studio, que también admite modelos MLX en Mac.
¿Qué significa si vas a comprar un Mac para IA local?
Ollama es gratis, así que la actualización no cuesta nada. Lo que limita es la memoria unificada, que en un Mac no se puede ampliar después:
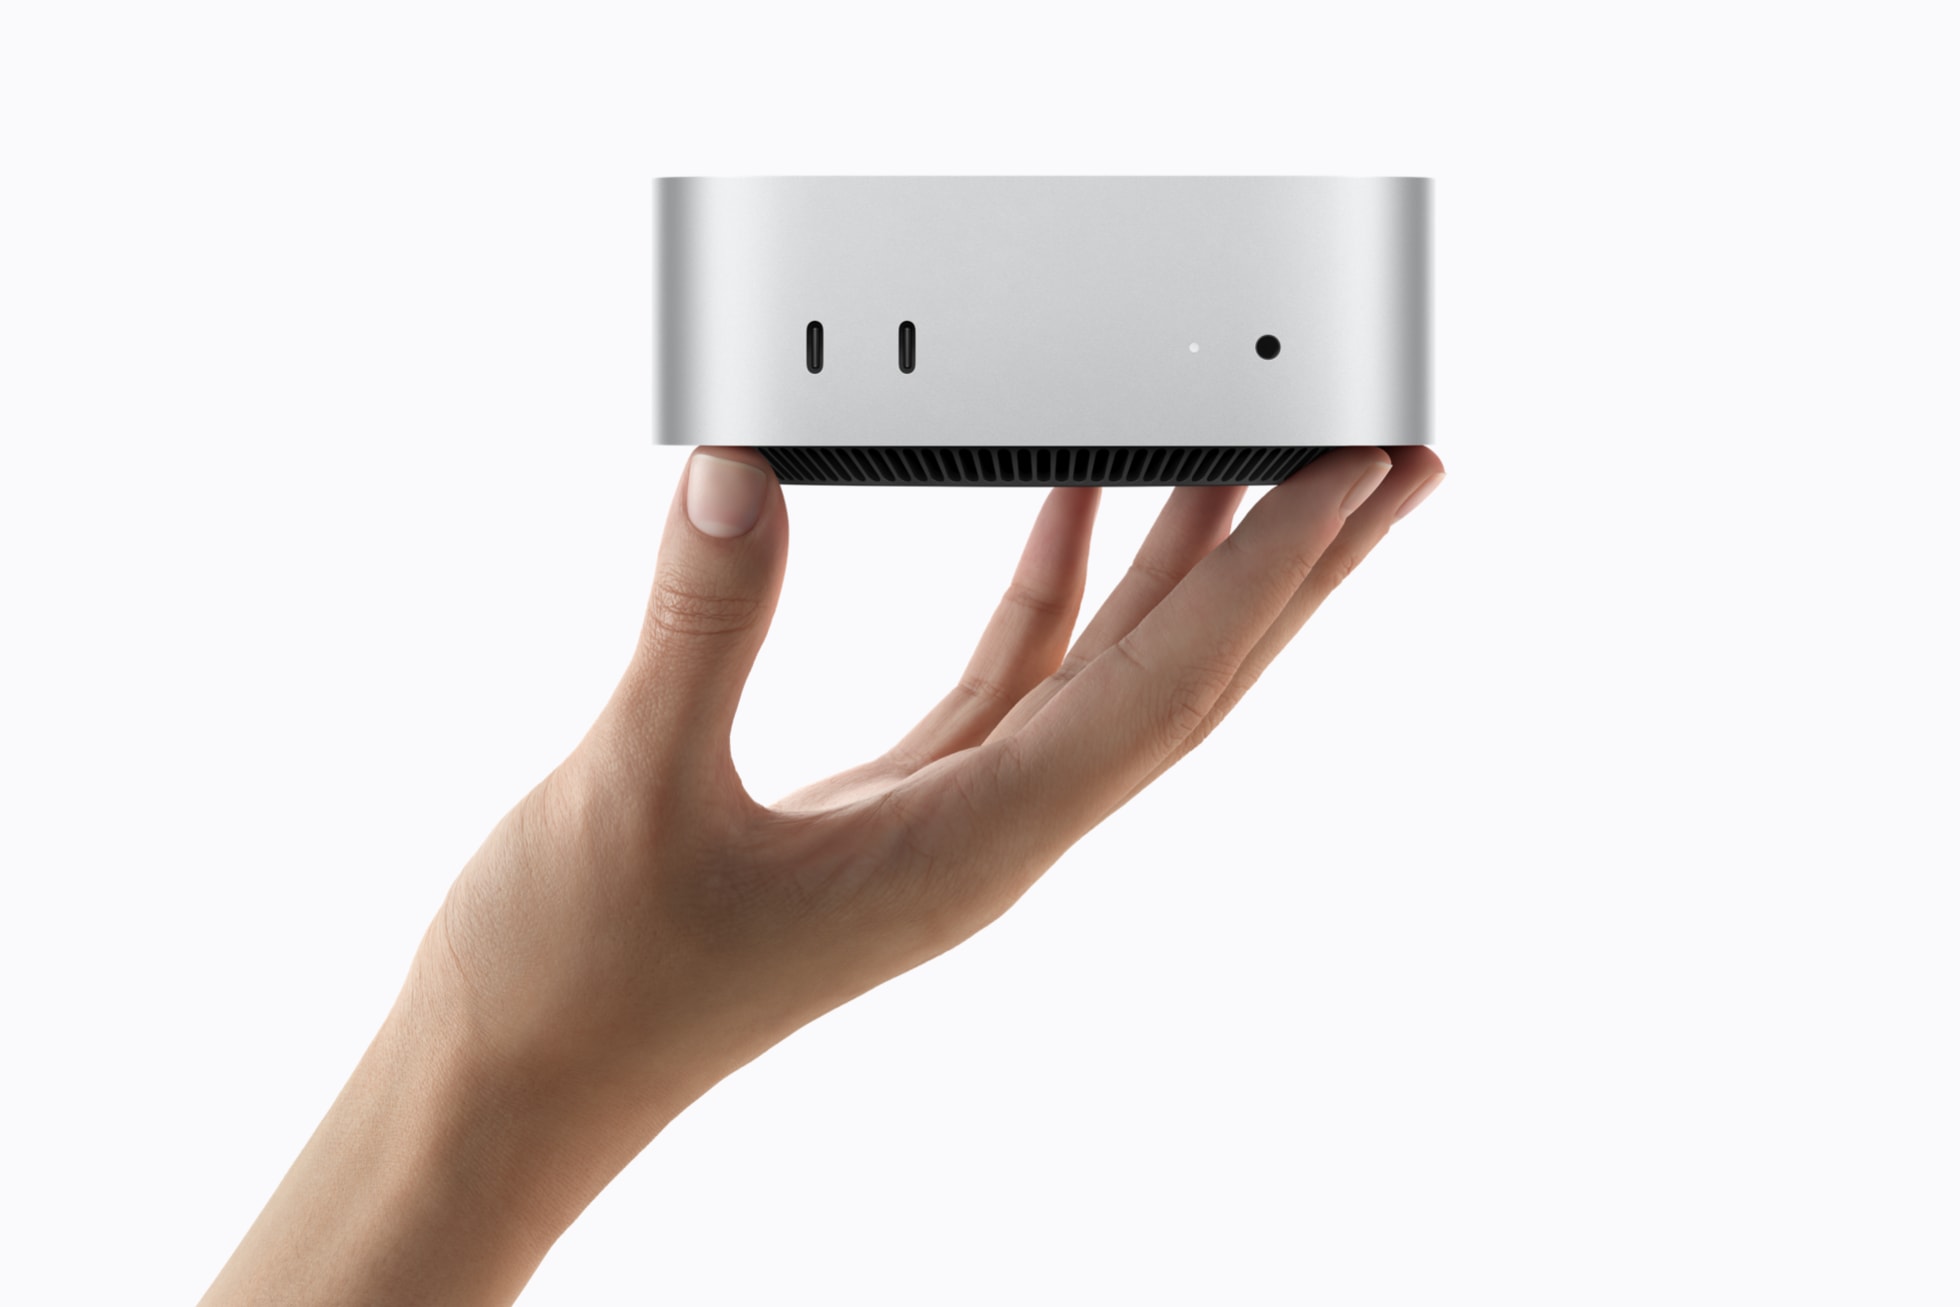
- El Mac mini con M6 cuesta en España desde 1.069 € en la tienda de Apple, con 16 GB de serie y opción de hasta 32 GB, según Apple.
- El Mac mini con M5 Pro parte de 2.019 € con 24 GB, y la tienda de Apple ofrece configuraciones de 64 GB.
Con 16 GB podrás usar modelos pequeños y medianos; si quieres modelos de unos 27.000 a 31.000 millones de parámetros, como Qwen3.8-27B, apunta a 32 GB o más. Si comparas con un PC, repasa qué gráfica comprar para IA local o un mini PC de memoria unificada como el Ryzen AI Max+ PRO 495 con 192 GB.
Nuestra opinión
Esto es opinión. Es una buena noticia para quien tiene un Mac con Apple Silicon: sin tocar nada, los modelos más populares pasan a usar el motor que Apple optimiza para sus chips. Aún no hemos encontrado opiniones de usuarios sobre la versión estable, publicada hace un día, y las cifras de velocidad son del propio Ollama. No compraríamos un Mac solo por esta actualización, pero si ya dudabas entre un Mac y un PC para IA local, refuerza la opción del Mac, siempre que elijas suficiente memoria desde el principio.
Preguntas frecuentes
¿Tengo que hacer algo para que Ollama use MLX en mi Mac?+
No. Basta con actualizar a Ollama 0.40.0. Si el modelo tiene una arquitectura compatible con el motor MLX de Ollama, se usa automáticamente; los comandos (ollama pull, ollama run) y la API son los mismos de siempre.
¿Qué modelos funcionan con MLX en Ollama 0.40?+
Las notas de la versión citan Qwen 3.8, Gemma 4, Qwen 3.6 y Qwen 3.5, los modelos de decisión Nimble, tev1, clef y clef-flash, y el modelo de embeddings EmbeddingGemma 2. Ollama dice que irá activando más modelos tras probarlos.
¿Cambia algo en Windows con una gráfica NVIDIA?+
No con esta versión. El cambio de la 0.40.0 afecta solo a los Mac con Apple Silicon. En Windows y Linux, Ollama sigue funcionando como hasta ahora.
¿Cuánta memoria necesita un Mac para la IA local con Ollama?+
Depende del modelo. Qwen 3.8 de 27.000 millones de parámetros ocupa 18 GB en Ollama, así que pide un Mac de 32 GB para ir holgado; con 16 GB hay que quedarse en modelos más pequeños, como Gemma 4 E4B o 12B, que ocupan menos de 10 GB.
Fuentes
- GitHub – Ollama v0.40.0 (notas de la versión)
- heise online – Local AI on the Mac: Ollama uses MLX as default (7 de octubre de 2026)
- Ollama Blog – Ollama is now powered by MLX on Apple Silicon in preview (30 de marzo de 2026)
- Ollama Blog – Ollama's highest performance on Apple Silicon yet with MLX (11 de junio de 2026)
- Ollama – Requisitos de macOS (documentación de la v0.40.0)
- Ollama Library – qwen3.8
- Ollama Library – gemma4
- El Rincón de Isma – Ollama defaults to MLX on Apple Silicon (27 de septiembre de 2026)
- Apple Newsroom – Apple presenta un Mac mini más potente con el nuevo M6 y el M5 Pro
- Apple Store España – Comprar Mac mini (precios)